Trong bài này
- Rút 20 triệu từ tài khoản 10 triệu
- Vì sao cần follower, và chúng không làm được gì
- Sync, async, semi-sync: leader đã hứa điều gì?
- Ba bước của failover
- Ba thảm họa
- 1. Mất dữ liệu, và kẻ mồ côi quay về
- 2. Split brain
- 3. Timeout sai
- Quorum: đa số, hoặc im lặng
- Núm vặn timeout
- Leaderless: W + R > N
- Read-your-own-writes
- Kết: các thần chú
Rút 20 triệu từ tài khoản 10 triệu
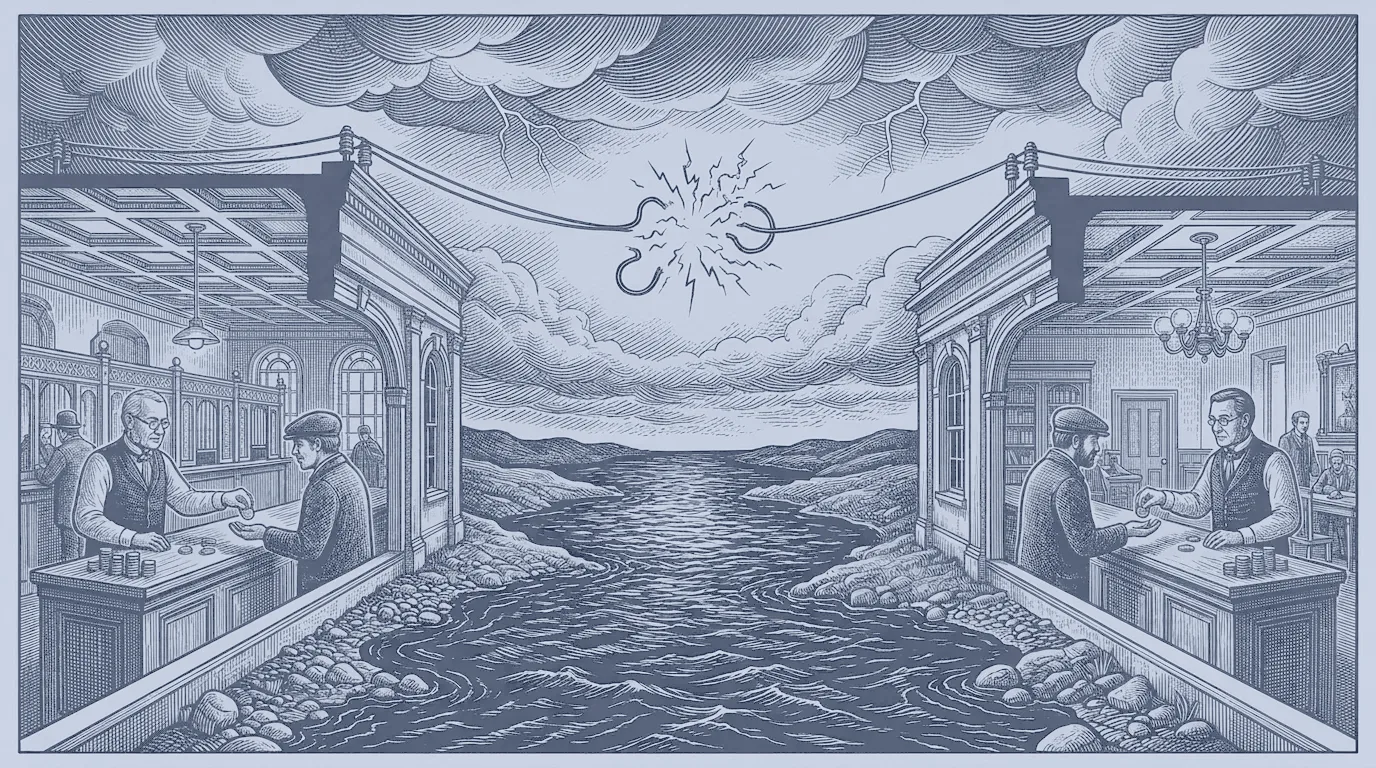
Đây là cảnh làm mình dừng đọc chương 5 của Designing Data-Intensive Applications (bản 1) để nhìn lên trần nhà. Một tài khoản có 10 triệu đồng. Sợi cáp nối data center Hà Nội và Sài Gòn bị cắt. Leader ở Hà Nội duyệt lệnh rút 10 triệu tại một chiếc ATM; leader ở Sài Gòn, cũng tin rằng mình đang nắm quyền, duyệt thêm một lệnh rút 10 triệu tại chiếc ATM khác. Hai mươi triệu ra khỏi một tài khoản chưa bao giờ có quá mười. Khi cáp được nối lại, không có cách nào hợp lý để hòa giải hai số dư.
Lần đầu tự diễn đạt chuyện này, mình viết một câu vụng về: "mạng bị chia làm hai, chỉ một bên nhận lệnh write nhưng follower lại follow bên kia, nên ghi nhận chuyển tiền mà không nhận được hàng." Chưa chính xác, nhưng cảm giác thì đúng, và đó là cảm giác mình muốn giữ suốt bài. Luận điểm gói trong một dòng: failover tự động là con dao hai lưỡi; có những sự cố lớn sinh ra từ chính failover chứ không phải từ chuyện leader chết. Còn lối thoát không phải là thông minh hơn, mà là bỏ phiếu theo đa số. Nếu bạn từng gặp phiên bản một máy của lỗi này, hai transaction ghi đè lên nhau, thì nó nằm trong bài chiếc vé cuối cùng; ở đây hai bên ghi không còn là hai thread mà là cả hai cỗ máy không nghe được nhau.
Vì sao cần follower, và chúng không làm được gì
Hai từ này hay bị dùng lẫn và không nên. Replication giữ một bản sao của toàn bộ dữ liệu trên nhiều máy: sống sót khi một máy chết và chia tải đọc. Partitioning (sharding, chương 6) cho mỗi máy một phần khác nhau của dữ liệu: chia tải ghi và chứa được dữ liệu lớn hơn một ổ đĩa. Hệ thống thật thường dùng cả hai: mỗi shard lại được replicate. Bài này nói về cái thứ nhất, cụ thể là kiểu phổ biến nhất: một leader và nhiều follower.
Đây là chỗ mình hiểu sai nhiều năm. Thêm follower có cảm giác như thêm công suất, vậy chắc cũng giúp ghi? Không. Follower phải nuốt 100% lượng ghi để theo kịp; mọi lệnh ghi leader nhận đều được phát lại trên từng follower. Mười follower nghĩa là mười máy, mỗi máy gánh trọn tải ghi, cộng thêm leader. Follower mua cho bạn tính sẵn sàng và băng thông đọc, không bao giờ là băng thông ghi. Nếu ghi là nút thắt, bạn phải partition.
- tải ghi mỗi follower vẫn phải gánh
- 1×
- bước trong một lần failover
- 3
- phiếu cần có trong cụm 5 máy
- 3 / 5
- quy tắc ngón tay cái của leaderless
- W+R>N
Sync, async, semi-sync: leader đã hứa điều gì?
Trước khi nói chuyện leader chết thế nào, hỏi một câu đơn giản hơn: khi leader báo "đã commit" cho client, thực sự có bao nhiêu máy đang giữ lệnh ghi đó? Câu trả lời là một cái núm vặn, và mỗi nấc là một lời hứa khác nhau.
| Chế độ | Leader báo xong khi | Nếu leader chết đột ngột | Hay dùng cho |
|---|---|---|---|
| Async | nó ghi xong ở máy mình | các lệnh ghi mới có thể mất (chưa kịp chép) | Mạng xã hội, bộ đếm lượt xem |
| Sync (tất cả) | mọi follower đã có | không mất gì, nhưng một follower chậm làm kẹt mọi lệnh ghi | Gần như không ai dùng |
| Semi-sync | leader + một follower được chọn đã có | dữ liệu có ở ít nhất hai máy | Ngân hàng, thanh toán, đơn hàng |
Ở câu này trực giác của mình đúng ngay lần đầu: ngân hàng cần cam kết đồng bộ (thực tế là semi-sync), mạng xã hội chịu được async. Không ai tiếc một cái like biến mất; ai cũng tiếc một lệnh chuyển tiền biến mất. Trong PostgreSQL, núm vặn này chỉ là vài dòng:
# semi-sync: COMMIT chỉ trả về khi BẤT KỲ 1 trong 2 standby này đã flush WAL
# (standby không nằm trong danh sách vẫn là async)
synchronous_standby_names = 'ANY 1 (replica_a, replica_b)'
synchronous_commit        = on     # on = chờ standby đó flush WAL xuống đĩa
# theo từng transaction, với lệnh ghi ít giá trị: SET LOCAL synchronous_commit = local;
Để ý ANY 1: standby nào trả lời trước cũng thỏa lời hứa, nên một replica chậm không làm đóng băng primary. (PostgreSQL gọi đây là quorum commit.) Giá phải trả là latency của mỗi commit, thêm một vòng tới follower, nên không ai để mọi thứ sync theo mặc định. Và vòng đi thêm đó rơi đúng vào cái đuôi chậm của thời gian phản hồi, chủ đề của bài về percentile.
Ba bước của failover
Hình ảnh của mình cho chuyện này là một công ty mà CEO gục ngã giữa quý. Hội đồng quản trị phải làm ba việc, theo thứ tự, trong áp lực:
- Nhận ra CEO không còn. Không có thầy bói nào báo cho ta. Công cụ duy nhất là timeout: nếu N giây không ai nghe tin từ leader, coi như nó đã chết.
- Bầu CEO mới. Thường là follower có dữ liệu mới nhất, vì mỗi lệnh ghi nó thiếu là một lệnh ghi biến mất.
- Chuyển hướng mọi người. Client và các follower khác phải gửi ghi tới, và replicate từ, leader mới. Leader cũ phải bị ép nhường quyền nếu nó quay lại.
Bước nào trong ba bước này là bước nguy hiểm? Hóa ra là cả ba. Mỗi bước ẩn một quyết định mà ngày xưa con người đưa ra lúc 3 giờ sáng với một ly cà phê. Tự động hóa nghĩa là bỏ con người, và kéo theo khả năng của con người nói "khoan, nhìn sai sai".
Ba thảm họa
1. Mất dữ liệu, và kẻ mồ côi quay về
Với replication async, vài quyết định cuối của CEO chưa được ghi lại ở đâu khác. Hội đồng bầu người kế nhiệm mà người đó chưa từng nghe chúng. Tệ hơn, CEO cũ có thể hồi phục và bước lại vào tòa nhà cùng những quyết định "mồ côi" đó. Cụm giờ phải lặng lẽ vứt chúng đi, hoặc hòa giải bằng tay.
2. Split brain
Chi nhánh Hà Nội và Sài Gòn mất liên lạc. Mỗi bên tự bỏ cuộc chờ CEO và bầu một CEO riêng, rồi hai CEO ban hành những mệnh lệnh trái ngược nhau. Đây là hai node cùng tin mình là leader và cùng nhận ghi. Không cần có bug nào: một script failover hoàn toàn đúng, chạy ở mỗi phía của một đường mạng bị cắt, sẽ cho ra đúng kết quả này. Đó là câu chuyện hai chiếc ATM ở đầu bài, và nếu không có cách phân xử ai thắng, dữ liệu sẽ phân kỳ vĩnh viễn.
3. Timeout sai
CEO chỉ đi vệ sinh năm phút mà hội đồng đã vội bầu người thay. Một leader chỉ đang chậm (một lần garbage collection dài, đĩa bận, đường truyền nghẽn) nhìn từ bên ngoài giống hệt một leader đã chết. Tuyên bố chết quá sớm thì bạn gây ra báo động giả: một lần failover không cần thiết mà tự nó làm cụm thêm tải, cụm chịu tải thì chậm hơn, và sinh thêm báo động giả. Tuyên bố chết quá muộn thì hệ thống đứng hình, lệnh ghi lỗi, trong một quãng dài. Phần dưới sẽ nói kỹ hơn về núm vặn này.
Quorum: đa số, hoặc im lặng
Cách sửa là một luật đơn giản đến mức nghe như đùa: một node chỉ được làm leader nếu hơn một nửa số node trong cụm đồng ý. Đó là quorum. Với năm node, quorum là ⌊5/2⌋ + 1 = 3 phiếu. Giờ cắt mạng thành một nhóm ba và một nhóm hai.
Phép toán chỉ có một dòng: hai nhóm bất kỳ mà mỗi nhóm nắm hơn một nửa số node bắt buộc chung ít nhất một node, và một node chỉ bỏ phiếu một lần trong mỗi cuộc bầu. Nên hai leader khác nhau không thể cùng thắng trong một term. Phe B không hỏng; nó trung thực rằng mình là thiểu số, và trả giá cho sự trung thực đó bằng việc không phục vụ được. Đây là một lựa chọn có chủ đích: khi mạng bị chia, hệ thống quorum hy sinh tính sẵn sàng ở phía nhỏ để bảo vệ tính nhất quán. Nó cũng giải thích vì sao hai data center là không đủ cho ngân hàng Hà Nội và Sài Gòn: cắt đường nối thì không bên nào có đa số, nên phiếu thứ ba phải nằm ở một nơi khác, một site thứ ba.
| Số node N | Quorum | Chịu được mất |
|---|---|---|
| 3 | 2 | 1 node |
| 4 | 3 | 1 node (không hơn cụm 3) |
| 5 | 3 | 2 node |
| 7 | 4 | 3 node |
Một lá phiếu một mình không chặn được leader cũ chưa hề biết mình đã bị thay, ví dụ vì đang bị đóng băng bởi một lần GC pause dài. Nên hệ thống production thêm hai công cụ nữa. Term number (Raft gọi là term, hệ khác gọi là epoch): mỗi cuộc bầu tăng một bộ đếm, và mọi message mang term cũ hơn đều bị bỏ qua; chương 9 là nơi chuyện này thành câu chuyện Raft và Paxos. Và fencing: một token tăng dần theo từng nhiệm kỳ leader, do chính tầng lưu trữ kiểm tra, để lệnh ghi của leader đã bị phế truất bị từ chối dù nó vẫn tưởng mình đang cầm quyền. Bản thô bạo là STONITH ("bắn vào đầu node kia"), cắt điện hoặc cắt mạng leader cũ trước khi leader mới bắt đầu. Nghe tàn nhẫn, và đó đúng là cách làm leader cũ phải dừng.
# sentinel.conf, trên mỗi sentinel trong 3 sentinel
# quorum 2: hai sentinel phải đồng ý master chết; rồi failover còn cần đa số
# toàn bộ sentinel cho phép một sentinel đứng ra thực hiện
sentinel monitor mymaster 10.0.0.1 6379 2
sentinel down-after-milliseconds mymaster 5000    # timeout: im lặng 5 giây = nghi ngờ
sentinel failover-timeout mymaster 60000

# redis.conf, trên master: từ chối ghi khi có quá ít replica theo kịp
min-replicas-to-write 1     # cần ít nhất 1 replica đang kết nối...
min-replicas-max-lag 10     # ...và lần ack gần nhất không cũ hơn 10 giây
Nhìn hai dòng cuối: một người anh em họ của ý tưởng quorum, thu nhỏ cho một node. Master không có replica nào ack trong 10 giây gần nhất thì ngừng nhận ghi, chọn im lặng thay vì trở thành một trong hai chiếc ATM. Đây là một giới hạn, không phải thuốc chữa: replication vẫn là async, nên một master bị cô lập vẫn có thể nhận khoảng 10 giây lệnh ghi rồi hóa thành lệnh mồ côi.
Núm vặn timeout
Timeout 5 giây hay 30 giây thì tốt hơn? Mình đã định chọn một con số, rồi nhận ra câu trả lời thật thà là không cái nào hơn, đó là hai loại chi phí khác nhau. Ở 5 giây, một lần GC pause dài hay một cú giật của mạng cloud là đủ để đuổi một leader còn khỏe, và lần failover không cần thiết lại làm cụm nặng thêm. Ở 30 giây, một lần sập thật nghĩa là nửa phút lệnh ghi lỗi, và cửa sổ dữ liệu chưa replicate lớn hơn trong cấu hình async.
Không có giá trị nào đúng ở mọi nơi; chỉ có giá trị khớp với nghiệp vụ của bạn. Dịch vụ thanh toán thà đứng ba mươi giây còn hơn duyệt hai lần; một news feed thà failover nhanh và mất vài bài đăng. Thói quen thực dụng: đặt timeout từ số đo thật (thời gian pause ở p99.9 cộng biên an toàn, xem bài về percentile), gọi người trực mỗi khi có failover thay vì để lúc khác mới thấy trong log, và diễn tập failover vào giờ vắng, đừng để lần đầu tiên là lúc 3 giờ sáng.
Leaderless: W + R > N
Một cách tránh cả vấn đề là không có leader. Trong các store kiểu Dynamo như Cassandra, một lệnh ghi đi tới W trong N replica và một lệnh đọc hỏi R replica. Luật: nếu W + R > N, tập replica bạn ghi tới và tập bạn đọc từ bắt buộc chung ít nhất một node, nên lệnh đọc luôn chạm vào một bản có lệnh ghi mới nhất. Cùng logic chuồng bồ câu như quorum.
| N | W | R | W + R | Đọc thấy lệnh ghi mới nhất? |
|---|---|---|---|---|
| 3 | 2 | 2 | 4 > 3 | Có (đảm bảo giao nhau) |
| 5 | 2 | 4 | 6 > 5 | Có: ghi rẻ, đọc đắt |
| 5 | 3 | 3 | 6 > 5 | Có: cân bằng |
| 3 | 1 | 1 | 2 ≤ 3 | Không: có thể đọc phải replica cũ |
Read-your-own-writes
Còn một bóng ma cuối sống ngay cả trong cụm khỏe mạnh. Bạn đổi tên hiển thị; lệnh ghi đi tới leader; trang tải lại và đọc từ một follower đang chậm hai giây; tên cũ hiện ra. Bạn tưởng lưu lỗi và bấm lại. Đó là vi phạm read-your-own-writes, và cách sửa phổ biến thì giản dị đúng như nghe: dữ liệu mà user có thể vừa sửa thì đọc từ leader, mọi thứ khác đọc từ follower. Các biến thể: đọc từ leader trong một phút sau mỗi lần user đó ghi, hoặc nhớ timestamp lần ghi cuối của họ và chỉ dùng follower đã bắt kịp mốc đó.
Kết: các thần chú
Leader không phải người tin rằng mình là leader. Leader là người mà đa số đồng ý.
Duy Anh, sau chương 5
- Follower cho bạn tính sẵn sàng và băng thông đọc, không bao giờ là băng thông ghi. Muốn scale ghi, hãy partition.
- Chọn sync, async hay semi-sync bằng cách hỏi bạn chịu được mất cái gì.
- Failover là ba bước (phát hiện, bầu, chuyển hướng) và bước nào cũng có thể hỏng. Failover tự động là con dao hai lưỡi.
- Chữa split brain bằng đa số: phe thiểu số phải im lặng. Thêm term number và fencing để leader bị phế truất không gây hại được.
- Leaderless: W + R > N làm lệnh đọc giao với lệnh ghi, nhưng đó là núm chỉnh, không phải chứng minh.
Quay lại hai chiếc ATM ở Hà Nội và Sài Gòn. Có một site thứ ba giữ lá phiếu quyết định, một chiếc tối màn hình vài phút và xin lỗi khách; chiếc kia trả mười triệu, đúng một lần. Một ngân hàng tạm thời không phục vụ được chỉ là phiền toái; một ngân hàng trả tiền hai lần là thảm họa. Nhưng bỏ phiếu đa số mới là nước đi mở đầu: những cỗ máy có thể chết và có thể im lặng làm sao thật sự đồng thuận được về điều gì? Đó là consensus, câu chuyện chương 9 trả lời đàng hoàng và là lý do Raft và Paxos tồn tại.
Nhưng trước consensus còn một cách giản dị hơn để làm đau một database: hỏi nó sai câu. Bài kế tiếp trong loạt này là thiếu một cái index và đường đi tới deadlock.